RAG (Retrieval-Augmented Generation) - курсы и уроки
RAG (Retrieval-Augmented Generation, генерация с дополнением поиском) — подход, при котором перед ответом модель получает фрагменты из внешних источников: документации, базы знаний, кода или логов. Так ответы опираются на актуальные и закрытые данные, которых не было в обучении модели. Типичный конвейер выглядит так: документы режут на фрагменты (чанки), переводят в эмбеддинги, хранят в векторной базе, по запросу находят ближайшие фрагменты, переранжируют их и передают в промпт. Для хранения используют Qdrant, Pinecone, pgvector или Elasticsearch, часто вместе с классическим полнотекстовым поиском. Термин ввели исследователи Facebook AI Research в статье 2020 года.
RAG решает две главные проблемы языковых моделей: они не знают ваших данных и уверенно отвечают даже тогда, когда ответа не знают. Подход применяют в ассистентах по внутренней документации и регламентам, поддержке клиентов, поиске по коду и тикетам, юридических и медицинских справочных системах, где важно показать источник ответа. Данные можно обновлять без переобучения модели, а права доступа проверять на этапе поиска. Большинство проблем в RAG возникают не в модели, а в поиске: неудачная нарезка документов разрывает смысл, эмбеддинги плохо находят точные термины и артикулы, а в контекст попадают устаревшие версии документов. Поэтому качество измеряют отдельно для поиска и для генерации, комбинируют векторный и полнотекстовый поиск и добавляют переранжирование.
Популярное в rag
AI Bootcamp: от RAG до агентов
Проектирование агентных ИИ-систем
RAG-боты и агенты LLM (большие языковые модели)
Spring AI: как надо, а не как все
Разработка RAG-систем, готовых к продакшену
Agentic RAG с DeepSeek-R1: интенсивный курс
Разработка персонального AI-ассистента на TypeScript
AI Инжиниринг Буткемп: Создание приложений на базе ИИ (LangChain, LLM API и другое)
Системный подход к совершенствованию RAG‑приложений
Популярные авторы и школы курсов в категории RAG


RAG в разделах

RAG: Список курсов
 Youssef Hosni
Другое (ИИ)AI-агентыRAG
Agentic RAG с DeepSeek-R1: интенсивный курс
Agentic RAG with DeepSeek-R1 Crash Course
Agentic RAG с DeepSeek-R1 — практический интенсивный курс по созданию агентной Retrieval-Augmented Generation системы на базе локальной LLM DeepSeek-R1. Вы пошагово соберёте рабочее приложение, в котором агенты, инструменты, задачи и RAG-компоненты взаимодействуют в едином workflow для поиска информации, рассуждения и генерации ответов.Курс ориентирован на практику: вместо абстрактной теории вы настраиваете локальную среду, запускаете DeepSeek-R1
 Youssef Hosni
Другое (ИИ)RAG
Разработка RAG-систем, готовых к продакшену
Designing Production Ready RAG System Crash Course
Production RAG — это не просто разбиение документов на фрагменты, создание эмбеддингов и передача найденного контекста в промпт. В реальном приложении RAG-система должна работать с PDF, сканами, изображениями, правами доступа, метаданными, несколькими хранилищами, очередями, фоновой обработкой, гибридным поиском и AI-агентами. На этом практическом курсе вы разберёте, как проектировать RAG-конвейер, готовый к продакшену, и интегрировать его в полн
 Иосиф Дзеранов
C Sharp (C#)Другое (ИИ)RAGLLM локально (Ollama, LM Studio)
ИИ-помощник на C# — интенсив
Собери работающего ИИ-помощника на C# за 4 вечера: подключи GigaChat, разберись с промптами, эмбеддингами, RAG и Function Calling, а в конце получи готовый проект для резюме и GitHub. Все занятия доступны в записи — проходи интенсив в удобном темпе.Кому подойдёт интенсивИнтенсив будет полезен тем, кто изучает C#, хочет выделиться среди других начинающих разработчиков и добавить в портфолио современный проект с искусственным интеллектом.Ученикам к
 Keerti Purswani
Другое (ИИ)AI-агентыRAG
Проектирование агентных ИИ-систем
Agentic AI System Design
Курс по проектированию агентных ИИ‑систем дает практическое понимание того, как создавать надежные, масштабируемые и производственные ИИ‑приложения на базе больших языковых моделей. Программа охватывает ключевые архитектурные подходы, инженерные практики и современные инструменты, необходимые для построения корпоративных интеллектуальных систем.Основы построения RAG‑системПервый модуль посвящен фундаментам Retrieval‑Augmented Generation и устройс
 Олег Филиппов
Другое (ИИ)AI-агентыRAG
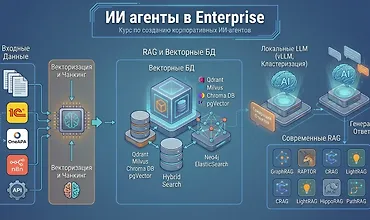
ИИ агенты в Enterprise (RAG)
Этот курс создан для специалистов, которые хотят эффективно внедрить ИИ‑агентов в корпоративную среду и научиться применять современные подходы RAG для работы с большими объемами знаний и документооборотом. Материал ориентирован на практику и реальные задачи бизнеса, включая экосистему 1С.Кому подойдет этот курсУ вас много неструктурированных данных, и вы хотите эффективно «подружить» их с ИИ.В компании есть база знаний, документация проектов, СЭ
 Alexey Grigorev
Другое (ИИ)AI-агентыAI-инженерияRAG
AI Bootcamp: от RAG до агентов
AI Bootcamp: From RAG to Agents
AI Bootcamp: от RAG до агентов — это интенсивная практическая программа, которая помогает разработчикам быстро перейти от базовой работы с LLM к созданию настоящих production-ready AI‑систем.Что вы узнаете и создадите на AI BootcampКурс построен вокруг полного цикла разработки современных AI-продуктов: от RAG‑систем и агентов до тестирования и продакшн‑мониторинга. Благодаря акценту на реальные инструменты и архитектуры вы создадите рабочие AI‑мо
 Zen van Riel
Другое (ИИ)RAGLLM (большие языковые модели)
Основы больших языковых моделей (LLM)
LLM Fundamentals
Этот курс помогает новичкам быстро и на практике освоить большие языковые модели (LLM), понять их устройство, научиться запускать локально и использовать для реальных задач. О курсеКурс представляет собой пошаговое обучение работе с современными LLM — от базовой теории до создания собственного AI‑сервиса. Подходит для начинающих и не требует глубоких знаний в программировании или нейросетях.Формат: видеолекции, практические ноутбуки и заданияДлит
 karpov.courses
Другое (ИИ)AI-агентыRAGLLM локально (Ollama, LM Studio)
RAG-боты и агенты LLM (большие языковые модели)
Если вы хотите уверенно создавать современных AI‑ассистентов, RAG‑ботов и инструменты на базе LLM, но не знаете, с чего начать — этот курс станет вашим пошаговым путеводителем. От no-code прототипов до Python‑бэкенда и MCP‑инструментов, вы освоите рабочие навыки, которые сейчас востребованы в компаниях и реальных проектах.Что делает этот курс особеннымМатериал выстроен так, чтобы вы понимали не только отдельные технологии, но и всю экосистему:
 Aurimas Griciūnas
Другое (ИИ)AI-агентыAI-инженерияRAG
End-to-End AI-инженерия: Bootcamp
End-to-End AI Engineering Bootcamp
End-to-End AI Engineering Bootcamp — это практический 8-недельный интенсив, который готовит специалистов к роли full‑stack AI-инженера. Вы освоите весь жизненный цикл создания AI-продукта: от архитектуры и прототипирования до продакшн-развертывания. Курс ведёт Ауримас Грицюнас — LinkedIn Top Voice in AI, экс‑CPO Neptune.ai и автор SwirlAI. Вас ждёт глубокая работа с Retrieval-Augmented Generation (RAG), агентными системами, памятью, интеграциями,
 Евгений Борисов
JavaSpringДругое (ИИ)RAGLLM локально (Ollama, LM Studio)
Spring AI: как надо, а не как все
Spring AI открывает массу возможностей для разработчиков, но правильная интеграция локальных LLM и построение надежной архитектуры — задача не из простых. Этот курс поможет вам освоить принципы, подходы и практики, которые позволяют внедрять AI в реальные сервисы так, чтобы всё работало стабильно, безопасно и эффективно.О курсеПрограмма предназначена для разработчиков уровня junior–middle, которые уже уверенно работают с Java и знакомы с основ
Узнать больше о RAG
Какие задачи решает RAG в реальных продуктах?
RAG позволяет модели отвечать по данным, которых не было в ее обучении: внутренней документации, базе знаний поддержки, договорам, регламентам, коду и тикетам. Типичные продукты — ассистент для сотрудников, который отвечает на вопросы по внутренним правилам, бот поддержки, опирающийся на справочный центр, поиск по технической документации с цитатами. RAG также снижает число выдуманных ответов: модель получает конкретные фрагменты и может сослаться на источник, а пользователь может проверить ответ. Еще одно преимущество — актуальность: при изменении документа достаточно переиндексировать его, модель переобучать не нужно.
Когда RAG подходит, а когда лучше выбрать другой подход?
RAG хорошо работает, когда ответ содержится в небольшом числе фрагментов текста: найти правило в регламенте, нужный раздел документации, описание товара. Он хуже справляется с вопросами, требующими агрегации по всем данным, например подсчитать все договоры с определенным условием: здесь лучше подходят SQL-запросы к структурированным данным. Если весь набор документов небольшой и помещается в контекстное окно, иногда проще передать его целиком. Если же нужно изменить стиль или формат ответов модели, а не дать ей знания, поможет дообучение или более точный промпт.
Чем RAG отличается от дообучения модели?
RAG добавляет знания во время запроса: система находит нужные фрагменты и вставляет их в промпт, а сама модель не меняется. Дообучение (fine-tuning) меняет веса модели на ваших примерах и лучше всего подходит для того, чтобы закрепить формат, стиль, терминологию или поведение. Для фактов RAG обычно надежнее: данные легко обновить, можно показать источник и разграничить доступ, а дообученная модель может смешивать и забывать факты. На практике подходы сочетают: модель дообучают под формат ответов предметной области, а актуальные данные получают через поиск.
Что нужно знать, чтобы построить свою первую RAG-систему?
Понадобится Python или TypeScript, работа с API языковой модели и базовое понимание эмбеддингов: как текст превращается в вектор и почему близкие по смыслу фрагменты оказываются рядом. Нужно уметь подготовить данные: извлечь текст из PDF и HTML, разбить его на фрагменты, сохранить метаданные. Затем стоит освоить одну векторную базу, например pgvector, если проект уже использует PostgreSQL, или Qdrant. Самый недооцененный навык — оценка: заранее собрать набор вопросов с правильными ответами и проверять, находит ли поиск нужные фрагменты, прежде чем настраивать промпт.
Кто использует RAG и в каких сценариях?
Строят RAG-системы AI-инженеры и backend-разработчики, а данные для них часто готовят дата-инженеры. Пользуются результатом самые разные отделы. Поддержка получает ассистента, который отвечает по справочному центру и предлагает операторам черновики ответов. Юристы и комплаенс ищут положения в договорах и регламентах. Разработчики задают вопросы по внутренней документации, коду и истории инцидентов. Отделы продаж находят ответы на технические вопросы клиентов. В крупных компаниях RAG часто становится общей платформой: один поисковый слой с учетом прав доступа обслуживает ассистентов для разных отделов.